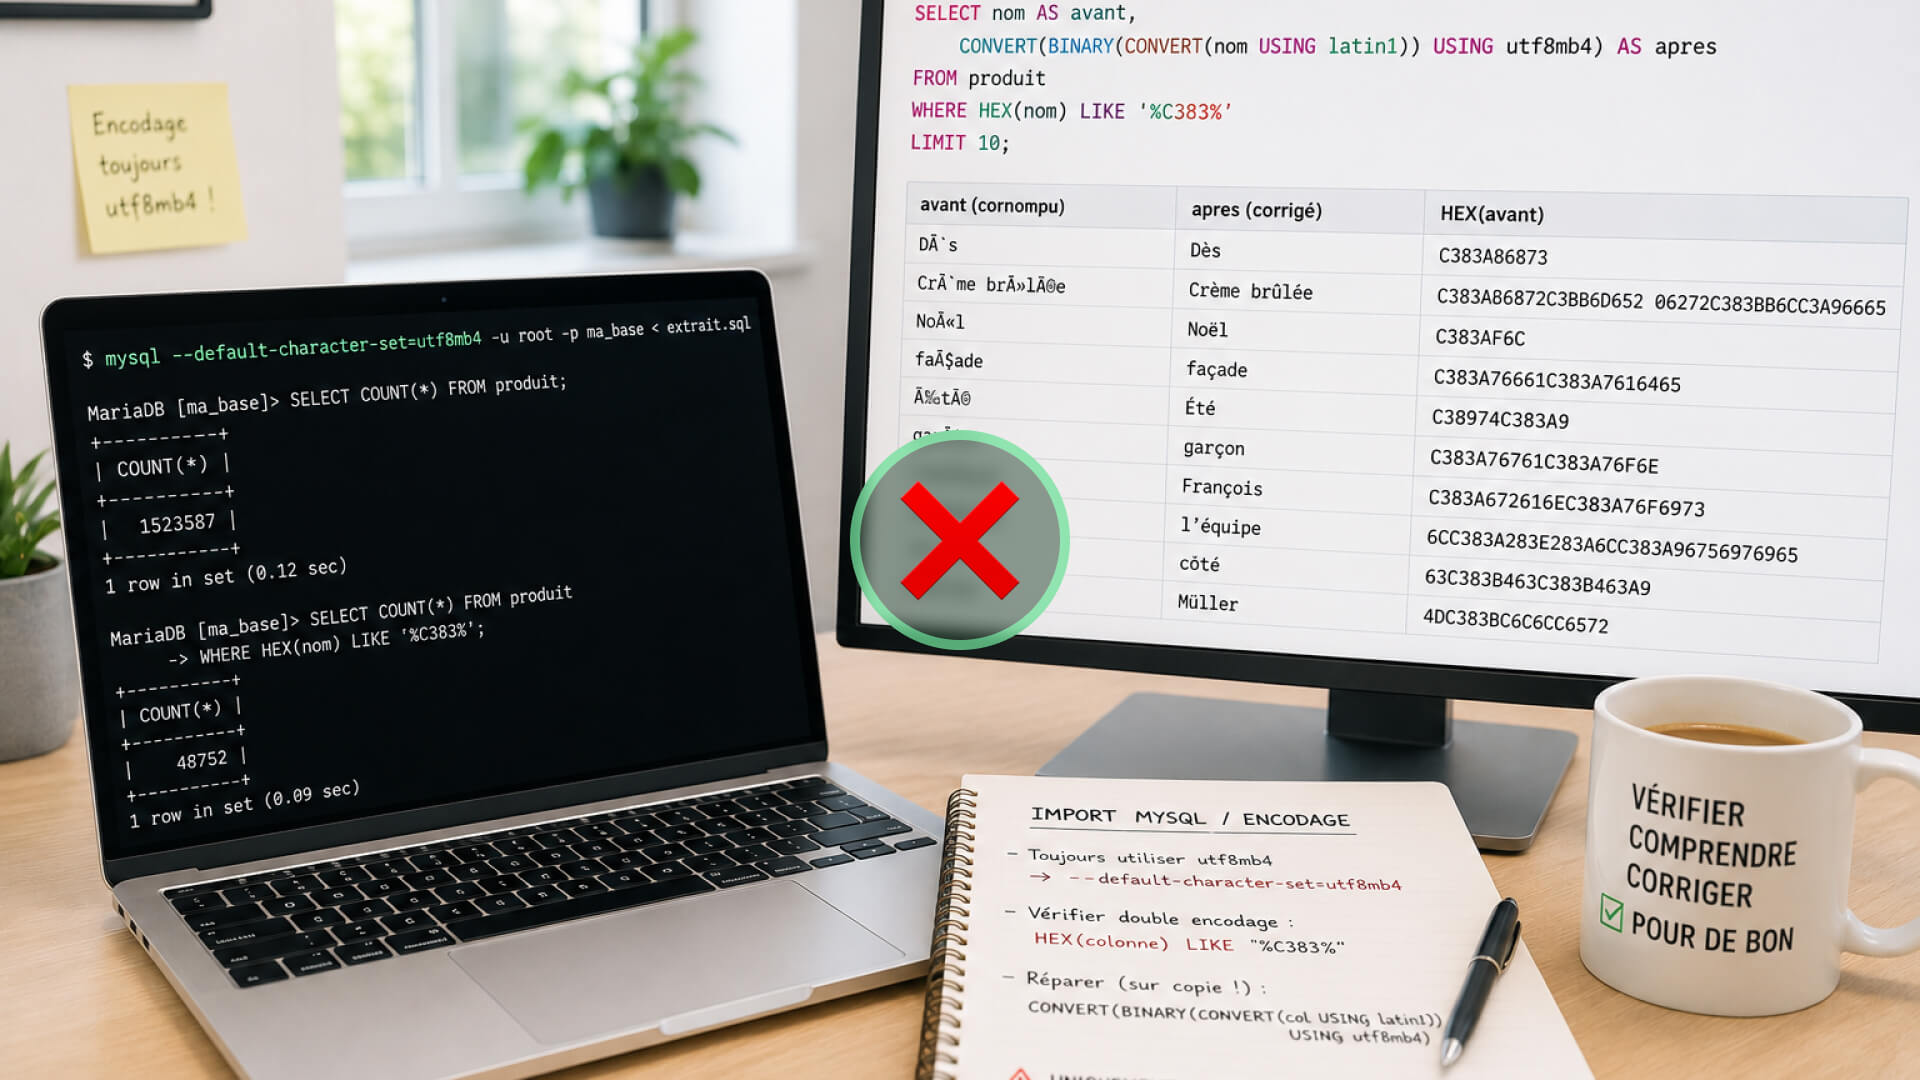
Vous importez un extrait de dump dans une base de travail. L’import se termine sans erreur. Vous comptez les lignes, le compte est bon. Vous comptez les enregistrements par table, le compte est bon aussi.
Et pourtant Dès est devenu Dès dans toute la base.
Comme le BOM UTF-8 qui casse des appels AJAX, ce piège est d’une banalité affligeante, il touche à peu près tout le monde une fois, et il est expliqué partout de travers. Voici ce qui se passe réellement, et surtout comment le reconnaître avant qu’il ne vous coûte une journée.
Le scénario
Rien d’exotique. On extrait une table d’un gros dump pour la recharger dans une base de travail :
gzip -cd dump.sql.gz | awk '...' > /tmp/extrait.sql
mysql -u<user> -p<pass> ma_base < /tmp/extrait.sql
Et tous les caractères accentués ressortent doublement encodés.
Le plus déroutant, c’est que le dump lui-même est parfaitement correct. Il contient bien la déclaration attendue :
SET character_set_client = utf8mb4;
Le fichier est bon. La base cible est en utf8mb4. Les tables aussi. Et le résultat est quand même corrompu.
Ce qui se passe vraiment
Le coupable est le client mysql en ligne de commande. Selon sa configuration et celle du système, il négocie souvent latin1 comme jeu de caractères de connexion par défaut.
Le déroulé est alors le suivant. Le fichier contient l’octet C3 A8, qui est la représentation UTF-8 correcte de è. Le client annonce au serveur qu’il parle latin1, donc le serveur interprète ces deux octets comme deux caractères latin1 distincts, Ã et ¨. Il les convertit consciencieusement vers l’utf8mb4 de la colonne de destination, ce qui donne quatre octets : C3 83 C2 A8.
L’information d’origine n’est pas perdue, elle est enveloppée une fois de trop. D’où le nom de double encodage.
Et le SET character_set_client = utf8mb4 présent dans le dump ? Il est bien exécuté, mais il ne s’applique qu’à partir du moment où le serveur le lit, et il peut être écrasé par la négociation de connexion du client. Sa présence dans le fichier ne garantit rien.
Le correctif
Une option, à l’import comme aux vérifications :
mysql --default-character-set=utf8mb4 -u<user> -p<pass> ma_base < /tmp/extrait.sql
C’est tout. Cette option force le jeu de caractères de la connexion et court-circuite la négociation par défaut.
Le piège dans le piège : il faut aussi la passer sur les SELECT de vérification. Sans elle, un client qui relit en latin1 des données correctement stockées vous les affichera corrompues, et vous conclurez à un problème qui n’existe pas. À l’inverse, un client mal configuré des deux côtés peut afficher correctement des données réellement abîmées, parce que les deux erreurs se compensent à l’affichage.
C’est ce qui rend le diagnostic à l’œil peu fiable : vous ne regardez jamais vos données, vous regardez vos données à travers un client.
Pourquoi ça passe sous les radars
C’est le point vraiment important, et la raison pour laquelle ce sujet mérite un article plutôt qu’une ligne dans un mémo.
Les contrôles de volume restent parfaitement corrects. Le nombre de lignes est bon. Le nombre de valeurs distinctes est bon. Les jointures fonctionnent. Les identifiants, les dates et les montants ne sont pas concernés, puisqu’ils ne contiennent pas de caractères non ASCII. Si votre vérification post-import se limite à comparer des COUNT(*), elle passera au vert sur une base intégralement corrompue.
Le décrochage arrive plus tard, et ailleurs. Ce qui casse en premier, ce sont les traitements qui normalisent du texte : un rapprochement de libellés, une recherche, un export vers un système tiers, un slug. Le lien avec l’import fait trois jours plus tôt n’a alors plus rien d’évident, et vous cherchez le bug dans le traitement plutôt que dans la donnée.
Comment le détecter à coup sûr
Ne vous fiez pas à l’affichage, regardez les octets. La séquence caractéristique du double encodage est C3 83, c’est-à-dire l’encodage UTF-8 du caractère à :
SELECT COUNT(*)
FROM ma_table
WHERE HEX(ma_colonne) LIKE '%C383%';
Zéro, vos données sont saines. Un nombre non nul, vous avez du double encodage, et le compte vous dit tout de suite l’ampleur.
Cette signature n’a rien d’approximatif. Les vingt-six caractères accentués du français, minuscules et majuscules confondues, de à à Ç, produisent tous la séquence C3 83 une fois doublement encodés. La raison est mécanique : leur point de code tombe dans la plage que l’UTF-8 encode avec un premier octet C3, et c’est ce C3 relu comme latin1 qui devient Ã, lui-même encodé C3 83. Sur un corpus francophone, la requête ne peut donc pas passer à côté.
Elle a par ailleurs l’avantage d’être indépendante du client, de son jeu de caractères et de votre terminal. Elle interroge la représentation physique en base, pas son rendu.
Passez ce contrôle en systématique après tout import, au même titre que les contrôles de mise en ligne et que vos vérifications de requêtes, au même titre que le comptage de lignes. Il coûte une requête et vous fait gagner la journée que coûte la découverte tardive.
Réparer une base déjà corrompue
Détecter ne suffit pas si le mal est fait. La bonne nouvelle, c’est que le double encodage est réversible sans perte : l’information d’origine n’a pas disparu, elle a été enveloppée une fois de trop. Il suffit de dérouler l’enveloppe dans l’autre sens.
-- Vérifier AVANT d'écrire : la colonne doit ressortir lisible
SELECT ma_colonne AS avant,
       CONVERT(BINARY(CONVERT(ma_colonne USING latin1)) USING utf8mb4) AS apres
FROM ma_table
WHERE HEX(ma_colonne) LIKE '%C383%'
LIMIT 20;

-- Puis seulement, et sur une copie de travail
UPDATE ma_table
SET ma_colonne = CONVERT(BINARY(CONVERT(ma_colonne USING latin1)) USING utf8mb4)
WHERE HEX(ma_colonne) LIKE '%C383%';
Deux précautions valent d’être répétées. La clause WHERE n’est pas décorative : appliquer la conversion à une ligne saine la corrompt, exactement en sens inverse. C’est une opération qu’on ne joue jamais deux fois, et jamais sur une table entière sans filtre.
Et si la conversion échoue sur une séquence invalide, ne forcez pas : cela signifie que la colonne mélange des lignes saines et corrompues, ou porte un encodage encore différent. La réparation se fait alors par lots identifiés, pas d’un seul UPDATE.
La variante MariaDB vers MySQL
Un cas voisin, moins connu, quand on déplace un dump depuis un MariaDB récent vers un MySQL 8.
MariaDB a introduit une famille de collations uca1400 qui n’existe pas côté MySQL. Un dump qui les mentionne dans ses CREATE TABLE échoue à l’import avec une erreur de collation inconnue, ce qui est le bon scénario : l’échec est franc et vous savez tout de suite quoi corriger.
Le mauvais scénario est celui où quelqu’un remplace ces collations à la va-vite par un sed sur le fichier, sans vérifier que la collation de remplacement a les mêmes propriétés de comparaison. Vous obtenez alors une base qui s’importe, qui fonctionne, et dont les tris et les comparaisons de chaînes se comportent différemment de la production. C’est une corruption d’un autre ordre : la donnée est intacte, c’est son interprétation qui a changé.
Ce qu’il faut en retenir
L’encodage n’est jamais une propriété d’un fichier ou d’une base isolément. C’est une propriété de toute la chaîne : le fichier, le client, la connexion, la table, la colonne, et le terminal qui affiche le résultat. Un maillon mal configuré suffit, et il n’a aucune raison de vous prévenir.
D’où deux règles simples, applicables dès aujourd’hui :
Passez toujours --default-character-set=utf8mb4 au client mysql, à l’import comme à la lecture. Mieux qu’un alias : posez-le une fois pour toutes dans votre configuration client, il s’appliquera à mysql, mysqldump et aux outils qui lisent ce fichier.
# ~/.my.cnf
[client]
default-character-set = utf8mb4

[mysql]
default-character-set = utf8mb4

[mysqldump]
default-character-set = utf8mb4
La section [client] couvre les outils qui la lisent, les deux autres verrouillent explicitement les deux commandes qui posent problème. Sur un serveur partagé ou dans une image Docker, le même contenu va dans /etc/mysql/conf.d/ : c’est le seul endroit où le réglage survit à l’oubli d’un collègue.
Et ajoutez le contrôle HEX(...) LIKE '%C383%' à votre routine de vérification post-import. Comptez les lignes pour vérifier que tout est arrivé, comptez les C383 pour vérifier que tout est arrivé intact. Ce sont deux questions différentes, et seule la première est habituellement posée.